שמות האירועים (events) הם הדבר הראשון שקוראים בכל תרשים של אנליטיקת מוצר. היום הם גם הדבר הראשון שה-AI של Amplitude קורא כששואלים אותו שאלה. קשה לשנות אותם אחרי שכבר נאספו תחתם נתונים, ולכן ההחלטה עליהם צריכה להתקבל לפני תחילת שליחת האירועים. את ההחלטה הזאת אנחנו כותבים בתוכנית מדידה. כאן תמצאו את כללי השמות שאנחנו עובדים לפיהם, ודוגמה שמראה את ההשפעה על תרשים ועל ה-AI של Amplitude.
אירוע אחד לכל פעולה, הפרטים במאפיינים
מודדים אירוע אחד לכל דבר שהמשתמש עושה, ואת הפרטים שמים במאפיינים (properties). כשקונה מכניס חלב לעגלה, האירוע הוא "Item added", והמאפיין item_name מקבל את שם המוצר. אירוע אחד מאפשר לספור בתרשים אחד את כל הפריטים שנוספו, ולפלח את הספירה לפי כל מאפיין כשצריך.
אותו פרט נקרא באותו שם בכל אירוע שבו הוא מופיע. item_name אומר אותו דבר ב-"Item added" וב-"Item removed", כך שאפשר לעקוב אחרי מוצר אחד בכל האירועים בלי לברר קודם ש-product באירוע אחד ו-item באירוע אחר הם אותו שדה.
לכתוב את המוסכמה: טקסונומיית האירועים
טקסונומיית אירועים (event taxonomy) היא אוסף הכללים ששמות האירועים והמאפיינים שלכם הולכים לפיהם. שלנו קצרה.
שמות אירועים: האובייקט ואחריו הפעולה, בזמן עבר, באות גדולה רק בתחילת השם (sentence case), עם רווח רגיל בין המילים. "Item added", "Purchase completed". כשהאובייקט בא ראשון, אירועים קשורים נשארים יחד ברשימה ממוינת אלפביתית, ו-"Item added" ו-"Item removed" עומדים זה ליד זה. זמן עבר מתאים למה שאירוע הוא: תיעוד של משהו שכבר קרה. שם עם רווחים ובלי אותיות גדולות מיותרות נקרא כמו משפט רגיל במקרא של תרשים.
שמות מאפיינים: snake_case. item_name, item_price. מילים באותיות קטנות שמחוברות בקו תחתון. ההבדל בין שני הסגנונות מכוון: שם של אירוע נקרא כמו משפט, שם של מאפיין נראה כמו שדה.
שמות באנגלית, גם כשהצוות עובד בעברית. כך כל צוות וכל כלי קוראים את אותם שמות, ולכן גם כל השמות בדוגמאות כאן באנגלית.
שמות שמסבירים את עצמם
אדם או AI צריכים להבין אירוע או מאפיין מהשם שלו בלבד. מבחן פשוט: האם אנליסט חדש, או ה-AI של Amplitude, היו צריכים לשאול מה הוא אומר? אם כן, כדאי לשנות את השם. שני הרגלים עוזרים.
- יחידת המידה בתוך השם, כשיש כזו.
item_price_ilsו-cart_value_ilsאומרים מה המטבע, ואף אחד לא צריך לנחש. - מאפייני כן/לא מתחילים ב-
is_או ב-has_.is_loyalty_memberיכול להיות רק true או false. מאפיין בשםloyaltyיכול להחזיק באותה מידה דרגת מועדון או יתרת נקודות.
המזהה שמחבר ביקור אחד
מוסיפים visit_id לכל אירוע בביקור. כך אפשר לשלוף את כל האירועים של ביקור אחד לפי הסדר: תחילת השימוש בעגלה, כל פריט שנוסף או הוצא ואיך הביקור הסתיים.
לקרוא את המסלולים, ולשאול את ה-AI
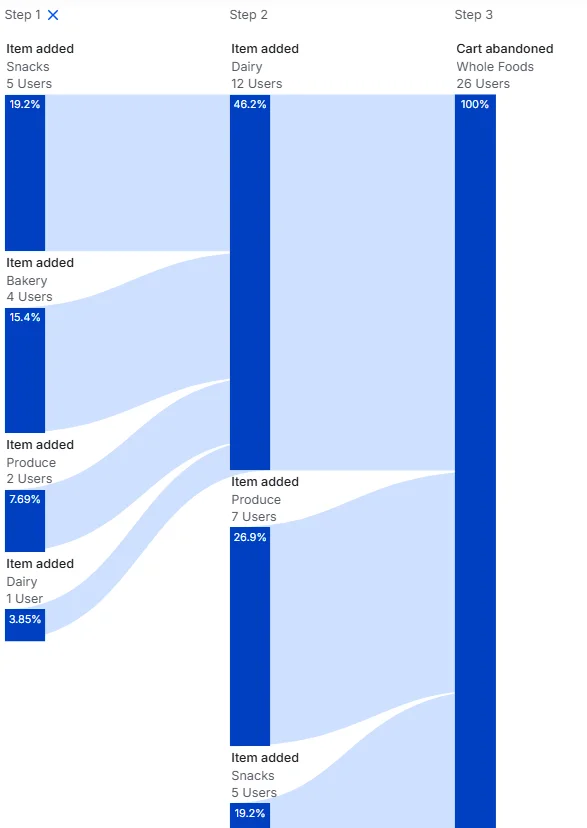
בפרויקט הדגמה ב-Amplitude שבנינו לפי הכללים האלה, יצרנו תרשים Pathfinder של המסלולים שמסתיימים ב-"Cart abandoned" ב-Whole Foods, כשהפריט האחרון שנוסף לפני כן מקובץ לפי item_category. מתוך 26 משתמשים, 12 הוסיפו לאחרונה פריט מ-Dairy (46.2%), 7 מ-Produce (26.9%) ו-5 מ-Snacks (19.2%). לא צריך מקרא כדי לקרוא את התרשים: "Item added" ו-"Cart abandoned" אומרים מה המשתמש עשה, ו-item_category אומר מה הם Dairy ו-Produce.
אחר כך שאלנו את ה-AI של Amplitude על אותם נתונים, במילים פשוטות.
You
Look at the last item added before carts were abandoned. Does any item or category stand out?
Amplitude AI
Key Standouts & Differences
- Whole Foods: Heavy Concentration in Dairy & Fresh Goods
- Dairy accounts for nearly half of all last-added items before abandonment at Whole Foods (46.2% / 12 users), followed by Produce (26.9% / 7 users).
- Together, fresh/perishable goods (Dairy + Produce) account for 73.1% of abandonment triggers at Whole Foods.
השאלה לא מזכירה אף אירוע ואף מאפיין. כדי לענות, ה-AI היה צריך להתאים בין "carts were abandoned" ל-"Cart abandoned" ובין "last item added" ל-"Item added", ואז לקבץ את הפריטים לפי item_category. הנתונים שהוא נתן ל-Whole Foods זהים לאלה שבתרשים, כלומר הוא מצא את האירוע והמאפיין הנכונים.
לפי התיעוד של Amplitude, ה-AI שלה עובד לפי השמות, שמות התצוגה והתיאורים של האירועים והמאפיינים (התיעוד של Amplitude (נפתח בכרטיסייה חדשה)). מכאן נגזרים עוד שני כללים.
- תיאור לכל אירוע ולכל מאפיין ב-Amplitude Data, שמסביר מה הוא אומר מבחינה עסקית ולא איך הוא ממומש. "The visit ends without payment" אומר ל-AI, וגם לאנשים בצוות, מה סופר "Cart abandoned".
- בלי כמעט-כפילויות. ממזגים או מסתירים אירועים ישנים ואירועי בדיקה, כך שיש ל-AI פחות אירועים שגויים לבחור מהם.
תוכנית המדידה
תוכנית המדידה היא המקום שבו הכללים האלה נשמרים: שורה לכל אירוע, מתי הוא נשלח ואילו מאפיינים הוא נושא. הנה דוגמה לעגלת קניות חכמה.
| אירוע | מתי הוא נשלח | מאפייני האירוע |
|---|---|---|
| Cart started | הקונה מתחיל להשתמש בעגלה | visit_id, store_chain, store_city |
| Item added | פריט נכנס לעגלה | visit_id, item_name, item_category, item_price_ils |
| Item removed | פריט יוצא מהעגלה | visit_id, item_name, item_category, item_price_ils |
| Purchase completed | הקונה משלם | visit_id, items_in_cart, cart_value_ils, payment_method, minutes_in_store |
| Cart abandoned | הביקור מסתיים בלי תשלום | visit_id, items_in_cart, cart_value_ils, minutes_in_store |
מאפייני משתמש: store_chain, store_city, is_loyalty_member.
לפני שמשיקים אירוע חדש
- השם בנוי מאובייקט ואחריו פעולה, בזמן עבר וב-sentence case.
- אין כבר אירוע שמכסה את אותה פעולה עם ערך אחר במאפיין.
- כל מאפיין כתוב ב-snake_case, ובאותו שם שיש לו באירועים אחרים.
- יחידת המידה מופיעה בשם, ומאפייני כן/לא מתחילים ב-
is_או ב-has_. - יש לו
visit_id. - יש לו תיאור עסקי ב-Amplitude Data, וכך גם לכל מאפיין חדש.
- הוא מופיע בתוכנית המדידה, עם בעלים.
- גרסאות ישנות או גרסאות בדיקה שלו מוזגו או הוסתרו.
רוצים תוכנית מדידה שגם הצוות וגם ה-AI של Amplitude יבינו? ראו איך אנחנו מקימים אנליטיקת מוצר.